किसी AI chatbot से सवाल पूछने पर हमें स्क्रीन पर कुछ ही सेकंड में जवाब दिखाई देता है। लेकिन उस जवाब के पीछे model को लगातार computation करना पड़ता है। खासकर जब लाखों लोग एक साथ AI service इस्तेमाल कर रहे हों, तब सवाल केवल यह नहीं रह जाता कि model कितना intelligent है। असली चुनौती यह भी है कि वह model कितनी तेजी से अपना जवाब generate कर सकता है।
AI की इसी समस्या को inference कहा जाता है और इसी workload को तेज करने के लिए Cerebras ने 19 अगस्त 2026 को अपना नया CS-4 system पेश किया। कंपनी के अनुसार CS-4 में उसका WSE-3 Turbo wafer-scale processor और Nexus server architecture इस्तेमाल किया गया है। Reuters के मुताबिक system को खास तौर पर AI chatbot inference को तेज करने के लिए design किया गया है और इसमें तीन chips plug-in modules के रूप में लगाए जाते हैं। यह system TSMC के 5nm process पर आधारित है और पिछली generation की तुलना में deployment के लिए 50% कम components का इस्तेमाल करता है।
Cerebras CS-4 क्या है?
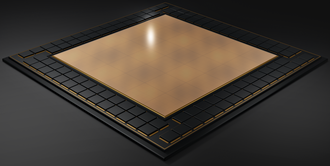
Cerebras CS-4 एक data-center AI computing system है, जिसे खास तौर पर AI inference और latency-sensitive workloads के लिए बनाया गया है। इसका सबसे महत्वपूर्ण हिस्सा Cerebras का wafer-scale processor है, यानी ऐसा processor जो सामान्य छोटे GPU package की जगह लगभग पूरी semiconductor wafer के बहुत बड़े हिस्से को एक computing platform की तरह इस्तेमाल करता है।
यहां एक महत्वपूर्ण फर्क समझना जरूरी है। CS-4 कोई सामान्य desktop AI chip नहीं है। यह बड़े AI infrastructure के लिए बनाया गया server-class system है। इसका लक्ष्य किसी एक PC को तेज बनाना नहीं, बल्कि बड़े AI models को ऐसे environment में run करना है जहां हर millisecond और हर token की generation speed मायने रखती है।
Cerebras की wafer-scale architecture में computation और memory को processor के बहुत बड़े surface पर पास-पास रखने की कोशिश की जाती है। कंपनी के WSE architecture में सैकड़ों हजारों processing elements और बड़े on-chip memory resources मौजूद हैं।
AI Inference क्या होता है?
AI model को दो बड़े चरणों में समझना आसान है। पहला है training, जिसमें model बहुत बड़े datasets से patterns सीखता है। दूसरा है inference, जिसमें trained model किसी नए input के आधार पर output तैयार करता है।
जब आप किसी AI chatbot को सवाल भेजते हैं, तब model training नहीं कर रहा होता। वह पहले से सीखी हुई parameters और computation का इस्तेमाल करके आपके input के आधार पर अगला token predict करता है। फिर अगला token, फिर अगला—और इसी तरह पूरा उत्तर तैयार होता है।
इसलिए chatbot की response speed केवल internet connection पर निर्भर नहीं करती। Backend में model को जिस hardware पर चलाया जा रहा है, उसकी compute capability, memory bandwidth, communication latency और software stack भी महत्वपूर्ण भूमिका निभाते हैं।
Chatbot का जवाब generate करते समय chip पर क्या होता है?
मान लीजिए आपने पूछा, “भारत में semiconductor industry क्यों महत्वपूर्ण है?” AI model आपके सवाल को tokens में बदलता है। फिर इन tokens और model parameters के आधार पर mathematical operations होते हैं। Model output में अगला token चुनता है और process आगे बढ़ता है।
एक छोटा जवाब भी कई sequential token-generation steps मांग सकता है। अगर hardware हर step के दौरान data को बार-बार अलग-अलग memory और processors के बीच भेजता रहे, तो communication और memory access latency बढ़ सकती है।
इस वजह से inference में केवल raw computing power काफी नहीं होती। Data कितनी तेजी से chip के अंदर move कर सकता है, यह भी response time को प्रभावित करता है। Cerebras अपने wafer-scale architecture को इसी memory और communication bottleneck को कम करने वाली design philosophy के रूप में पेश करता है।
Wafer-scale AI chip क्या है?
सामान्य semiconductor manufacturing में एक silicon wafer पर बहुत सारे छोटे chips बनाए जाते हैं। बाद में इन्हें अलग-अलग काटकर packages में लगाया जाता है। Cerebras ने इसके उलट approach अपनाई है: बहुत बड़े हिस्से को एक single computing unit के रूप में इस्तेमाल करना।
इसे ऐसे समझें जैसे किसी बड़े शहर में कई छोटे offices अलग-अलग इमारतों में हों और उन्हें लगातार आपस में data भेजना पड़े। दूसरी तरफ एक बहुत बड़ा campus हो जिसमें सभी teams एक ही परिसर में हों। दोनों जगह कुल computing resources बड़े हो सकते हैं, लेकिन internal communication का तरीका अलग होगा।
Cerebras की wafer-scale architecture का उद्देश्य इसी तरह processing elements को एक विशाल chip surface पर tightly connected रखना है। कंपनी ने पहले WSE architecture में communication latency कम करने और high-bandwidth on-chip communication को प्रमुख advantage बताया है।
WSE-3 Turbo क्या करता है?
CS-4 में इस्तेमाल होने वाला WSE-3 Turbo Cerebras के wafer-scale processor architecture का नया inference-focused रूप है। इसका काम AI model के computations को बड़े number of processing elements पर execute करना और data movement को efficient रखना है।
Cerebras के पुराने WSE-3 में 900,000 processing elements, 44GB on-chip memory और 21 petabytes per second तक memory bandwidth जैसे specifications बताए गए हैं। WSE-3 को CS-3 system में deploy किया जाता था। CS-4 में कंपनी ने इसी wafer-scale concept को नए system architecture और upgraded networking के साथ आगे बढ़ाया है।
यहां ध्यान रखना जरूरी है कि WSE-3 के published specifications और CS-4 के नए system-level claims को एक ही चीज नहीं समझना चाहिए। CS-4 एक पूरा system है, जबकि WSE-3 Turbo उसका प्रमुख processor component है।
Nexus Architecture की भूमिका क्या है?
CS-4 का दूसरा महत्वपूर्ण हिस्सा Nexus server architecture है। Reuters के अनुसार इसमें तीन Cerebras chips plug-in modules की तरह इस्तेमाल किए जाते हैं। इसका उद्देश्य केवल ज्यादा chips जोड़ना नहीं है, बल्कि server architecture के अंदर communication और deployment को ज्यादा efficient बनाना है।
AI inference में यह महत्वपूर्ण है क्योंकि कई users के requests एक साथ process हो सकते हैं। Hardware को model computation के साथ-साथ अलग-अलग components के बीच information exchange भी संभालना पड़ता है। अगर communication bottleneck बन जाए तो बहुत powerful processor होने के बावजूद end-user को response जल्दी नहीं मिलेगा।
Cerebras CS-4 AI inference को तेज कैसे करता है?
CS-4 की approach को तीन मुख्य ideas में समझा जा सकता है।
1. बहुत बड़ा computing surface
Wafer-scale processor में सामान्य GPU की तुलना में बहुत बड़ा physical computing area होता है। इससे बड़ी संख्या में processing elements को एक tightly connected fabric में रखा जा सकता है। Cerebras के अनुसार WSE architecture का उद्देश्य distributed computing में होने वाले communication overhead को कम करना है।
2. High memory bandwidth
AI inference में model parameters और intermediate data को तेजी से access करना जरूरी है। Cerebras ने अपने WSE architecture में बहुत high memory bandwidth को प्रमुख feature बनाया है। कंपनी के पहले published WSE-3 materials में 21 petabytes per second memory bandwidth का आंकड़ा दिया गया है।
जितनी तेजी से processor relevant data तक पहुंच सके, उतनी कम संभावना होती है कि compute units data का इंतजार करते हुए idle रहें। हालांकि वास्तविक performance model architecture, batch size, workload और software optimization पर भी निर्भर करती है।
3. Communication latency कम करने की कोशिश
जब model को कई अलग-अलग chips में बांटकर चलाना पड़ता है, तो processors के बीच communication की जरूरत बढ़ती है। Cerebras का wafer-scale approach processing resources को एक बहुत बड़े connected surface पर रखने की कोशिश करता है। इससे कुछ workloads में data movement और inter-chip communication को कम किया जा सकता है।
Cerebras CS-4 और GPU में क्या अंतर है?
| GPU आधारित AI Infrastructure | Cerebras CS-4 Approach |
|---|---|
| अलग-अलग GPU chips को बड़े systems और networks में जोड़ा जा सकता है। | बहुत बड़े wafer-scale processor और dedicated system architecture पर जोर है। |
| Multi-chip communication महत्वपूर्ण design challenge बन सकता है। | Wafer-scale fabric के जरिए communication distance और overhead कम करने की कोशिश होती है। |
| GPU ecosystem बहुत व्यापक और mature है। | Cerebras का ecosystem ज्यादा specialized wafer-scale architecture पर केंद्रित है। |
| Training और inference दोनों के लिए बड़े पैमाने पर इस्तेमाल होता है। | CS-4 का current positioning inference और latency-sensitive AI workloads पर विशेष जोर देता है। |
इस तुलना का मतलब यह नहीं है कि CS-4 हर workload में GPU से बेहतर है। AI infrastructure में performance model, software compatibility, networking, cost, memory requirements और workload characteristics पर निर्भर करती है। Cerebras का लक्ष्य एक अलग architectural trade-off पेश करना है।
क्या CS-4 ChatGPT जैसे AI को तुरंत तेज कर देगा?
यहां भी एक जरूरी distinction है। किसी AI service की total response time केवल chip से तय नहीं होती। Model architecture, request routing, network, software stack, queueing, context length और service configuration सभी असर डालते हैं।
CS-4 का उद्देश्य inference hardware को तेज बनाना है, जिससे token generation latency कम करने में मदद मिल सके। Cerebras पहले से inference services उपलब्ध करा रहा है और कंपनी अपने infrastructure को low-latency AI applications के लिए position करती है।
इसलिए “CS-4 लगाते ही हर chatbot का जवाब उतनी ही तेजी से आएगा” कहना सही नहीं होगा। सही बात यह है कि ऐसी hardware architecture AI inference के उस हिस्से को तेज करने की कोशिश करती है जो token generation और model computation से जुड़ा है।
AI inference के लिए GPU का विकल्प क्यों खोजा जा रहा है?
AI models के आकार और उपयोगकर्ताओं की संख्या बढ़ने के साथ inference infrastructure की मांग भी बढ़ रही है। Training के समय model को सीखने के लिए भारी computation चाहिए, लेकिन deployment के बाद वही model लाखों या करोड़ों requests का जवाब दे सकता है।
इस स्थिति में latency और cost दोनों महत्वपूर्ण हो जाते हैं। हर user को response देने के लिए बहुत अधिक hardware चलाना पड़े तो AI service महंगी हो सकती है। दूसरी ओर response धीमा हो तो real-time applications, AI agents और interactive systems का अनुभव खराब हो सकता है।
Cerebras का architecture इसी market में GPU के साथ alternative approach देने की कोशिश करता है। कंपनी के 2026 filings में inference को AI infrastructure का तेजी से बढ़ता हुआ हिस्सा बताया गया है।
CS-4 में 5nm process का क्या महत्व है?
CS-4 का processor TSMC के 5nm process पर fabricated है। छोटा process node सामान्यतः ज्यादा transistor density और बेहतर power-performance trade-offs के अवसर दे सकता है, हालांकि केवल process node देखकर किसी पूरे system की efficiency तय नहीं की जा सकती। Architecture, cooling, memory, interconnect और workload optimization भी उतने ही महत्वपूर्ण हैं।
CS-4 के मामले में Cerebras ने system deployment को सरल बनाने पर भी जोर दिया है। Reuters के अनुसार कंपनी का कहना है कि नई system design पिछली generation की तुलना में 50% कम components इस्तेमाल करती है।
Agentic AI के लिए ऐसी chip क्यों उपयोगी हो सकती है?
AI agents सामान्य chatbot से अलग होते हैं। वे किसी लक्ष्य को पूरा करने के लिए कई model calls, tool calls और decision steps कर सकते हैं। एक agent को अगर बार-बार model inference करना पड़े, तो हर request की latency पूरे workflow को धीमा कर सकती है।
उदाहरण के लिए कोई agent पहले सवाल समझे, फिर database search करे, फिर calculation करे, फिर result की जांच करे और अंत में user को जवाब दे। अगर हर AI inference बहुत कम latency में पूरा हो, तो पूरा interaction ज्यादा responsive बन सकता है।
इसी वजह से low-latency inference hardware का महत्व केवल chatbots तक सीमित नहीं है। Real-time assistants, coding agents, robotics और अन्य interactive AI systems में भी inference speed महत्वपूर्ण हो सकती है। Cerebras अपने current inference platform को agentic workloads के लिए भी position करता है।
CS-4 की सीमाएं क्या हैं?
सबसे पहली सीमा ecosystem की है। Nvidia के GPUs के आसपास लंबे समय से mature software, libraries, frameworks और developer tools का बड़ा ecosystem बना हुआ है। किसी alternative accelerator को केवल hardware performance से नहीं, बल्कि software compatibility और deployment experience से भी प्रतिस्पर्धा करनी होती है।
दूसरी चुनौती cost और scale है। Wafer-scale processor का निर्माण और packaging सामान्य accelerator से अलग engineering challenges पैदा करता है। ऐसे systems को data-center level power delivery, cooling और networking की जरूरत होती है।
तीसरी बात performance claims की है। Cerebras और अन्य hardware vendors द्वारा बताए गए benchmark results specific models और configurations पर आधारित हो सकते हैं। इसलिए एक benchmark में तेज परिणाम को हर AI model या हर workload पर universal advantage नहीं माना जाना चाहिए।
और चौथी चुनौती commercial scale है। Reuters ने अगस्त 2026 में Cerebras के quarterly results पर market concerns भी report किए थे, जिनमें Nvidia के साथ प्रतिस्पर्धा और profitable scaling को लेकर सवाल शामिल थे।
क्या Cerebras CS-4 GPU को replace कर देगा?
अभी ऐसा कहना जल्दबाजी होगी। AI infrastructure एक single-chip market नहीं है। अलग workloads के लिए अलग hardware बेहतर हो सकता है। GPU general-purpose parallel AI computation में मजबूत हैं, जबकि Cerebras wafer-scale architecture खास तौर पर high-speed inference और बड़े-scale AI computation में अलग trade-offs देने की कोशिश करता है।
ज्यादा संभावित भविष्य ऐसा है जिसमें GPUs, wafer-scale processors और अन्य specialized AI accelerators साथ-साथ इस्तेमाल होंगे। Cloud providers और AI companies workload के आधार पर तय कर सकती हैं कि training के लिए कौन-सा hardware, inference के लिए कौन-सा और latency-sensitive applications के लिए कौन-सा architecture बेहतर है।
AI की अगली लड़ाई केवल बड़े models की नहीं है
AI industry में लंबे समय तक चर्चा इस बात पर रही कि model में कितने parameters हैं और उसे train करने के लिए कितनी computing power चाहिए। अब एक दूसरी समस्या तेजी से महत्वपूर्ण हो रही है: trained model को हर user तक कितनी तेजी से पहुंचाया जाए।
यहीं inference hardware की भूमिका बढ़ती है। Cerebras CS-4 इस बदलाव का एक उदाहरण है। इसका मूल विचार यह है कि AI response generation में speed बढ़ाने के लिए केवल ज्यादा processors जोड़ना जरूरी नहीं; processor की architecture, memory placement और communication network को भी fundamentally अलग तरीके से design किया जा सकता है।
कुल मिलाकर
Cerebras CS-4 क्या है? इसे समझने का सबसे आसान तरीका है—यह एक specialized AI inference system है जो wafer-scale computing को नए server architecture के साथ जोड़कर AI responses को तेज बनाने की कोशिश करता है। इसका WSE-3 Turbo processor बहुत बड़े computing surface, high-bandwidth on-chip resources और tightly connected processing architecture पर आधारित है।
इसका महत्व केवल Cerebras के नए product तक सीमित नहीं है। यह दिखाता है कि AI hardware की अगली competition केवल “किस chip में ज्यादा compute है” तक सीमित नहीं रहेगी। Memory bandwidth, data movement, communication latency और token generation speed जैसे factors भी उतने ही महत्वपूर्ण होंगे।
CS-4 को GPU का निश्चित replacement कहना अभी सही नहीं है। लेकिन अगर AI applications में real-time responses, AI agents और लगातार inference की मांग बढ़ती है, तो Cerebras जैसी wafer-scale architectures AI data centers में एक महत्वपूर्ण alternative बन सकती हैं। फिलहाल इसकी वास्तविक स्थिति को समझने का सबसे सही तरीका यही है कि इसे AI inference को तेज करने के लिए बनाया गया specialized architecture माना जाए, न कि हर तरह के AI workload के लिए universal replacement।
FAQ
Cerebras CS-4 क्या है?
Cerebras CS-4 एक data-center AI computing system है जिसे मुख्य रूप से fast AI inference और latency-sensitive workloads के लिए बनाया गया है। इसमें WSE-3 Turbo wafer-scale processor और Nexus server architecture का इस्तेमाल किया गया है।
AI inference क्या होता है?
Inference वह चरण है जिसमें पहले से trained AI model किसी नए input के आधार पर output generate करता है। Chatbot में user का सवाल पढ़कर उत्तर के tokens generate करना inference का उदाहरण है।
Wafer-scale AI chip क्या है?
Wafer-scale AI chip में semiconductor wafer के बहुत बड़े हिस्से को एक विशाल computing unit की तरह इस्तेमाल किया जाता है। इसका उद्देश्य processing elements और memory के बीच communication को efficient बनाना है।
Cerebras CS-4 और GPU में क्या अंतर है?
GPU-based systems आम तौर पर अनेक accelerator chips को memory और high-speed networks के साथ जोड़ते हैं। Cerebras CS-4 wafer-scale processor और tightly integrated system architecture पर आधारित अलग approach अपनाता है।
क्या Cerebras CS-4 GPU का विकल्प बन सकता है?
कुछ inference workloads में यह GPU-based systems का alternative हो सकता है, लेकिन इसे हर AI workload के लिए GPU replacement कहना अभी उचित नहीं है। Performance workload, model, software और deployment configuration पर निर्भर करती है।